¿Qué es el Harness Engineering? La ingeniería detrás de los agentes de IA
Qué es el Harness Engineering, qué piezas forman el sistema que rodea a un modelo de IA y por qué tools, contexto, permisos, verificación y evals importan tanto como el propio modelo.
Durante mucho tiempo, cuando un agente de IA fallaba, la reacción más habitual era tocar el prompt o probar un modelo mejor. Sigue teniendo sentido hacerlo, pero hay otra parte del sistema que cada vez pesa más: todo lo que rodea al modelo.
Un agente de desarrollo puede buscar código, abrir archivos, modificar un repositorio, ejecutar tests, consultar documentación y continuar trabajando durante muchos pasos. El modelo, por sí solo, no hace ninguna de esas cosas sobre tu máquina. Decide qué quiere hacer y genera la salida correspondiente. Hay otro software que convierte esa decisión en una acción real.
Ese software es el harness.
El modelo aporta la capacidad de razonar sobre la tarea. El harness le da un entorno donde esa capacidad puede convertirse en trabajo: tools, acceso a archivos, estado, contexto, permisos, ejecución de comandos, validaciones y bucles de feedback.
Diseñar y mejorar esa capa es lo que hoy se suele llamar Harness Engineering.
El modelo no es todo el agente
Imagina que le pides a un agente de coding algo concreto:
Añade a un Lightning Web Component un indicador visual para oportunidades con riesgo alto y cubre el cambio con tests.
Para resolverlo bien, el agente necesita localizar el componente, entender de dónde llega el dato de riesgo, revisar si existe lógica Apex relacionada, modificar los archivos correctos, ejecutar los tests de Jest y Apex y comprobar que no ha roto nada.
El modelo puede decidir que primero necesita encontrar la LWC. Pero buscar en tu repositorio requiere acceso al filesystem. Puede proponer un cambio, pero escribirlo requiere una herramienta de edición. Puede decidir que los tests deben ejecutarse, pero alguien tiene que lanzar el comando y devolverle el resultado.
El ciclo real se parece más a esto:
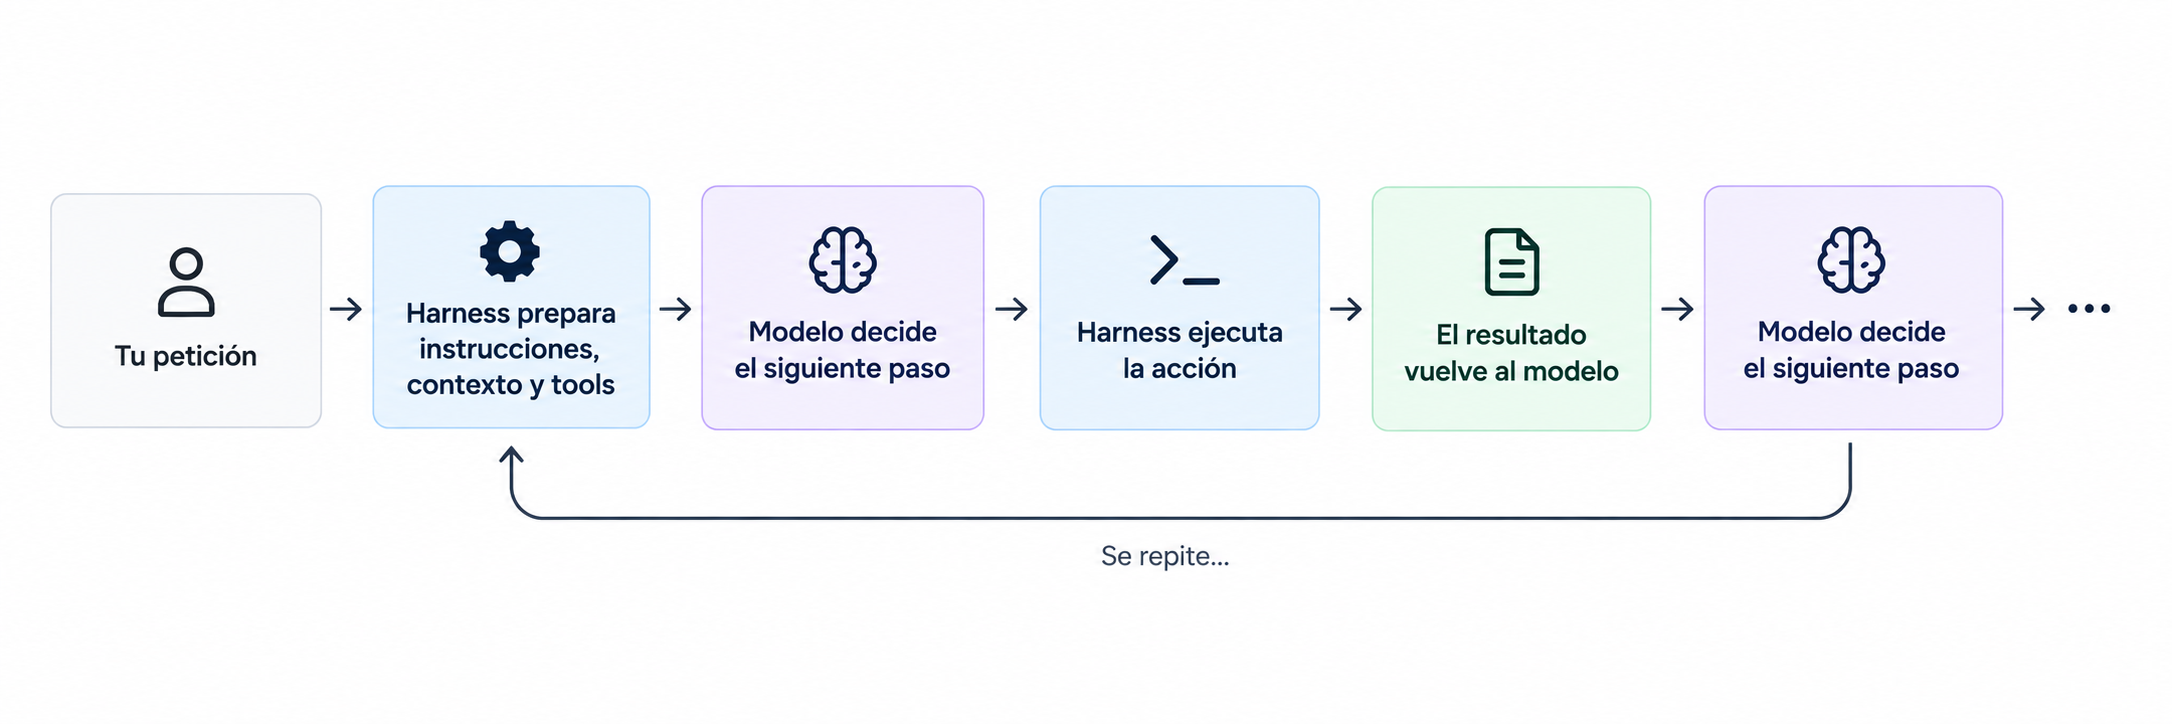
Cuando ves a Codex, Claude Code u otro agente navegar por un proyecto, no estás viendo al modelo actuar directamente sobre el ordenador. Estás viendo una colaboración entre el modelo y el software que lo rodea.
Un claro ejemplo de un buen harness es openclaw y cómo está configurado de tal forma que permite tener un agente "vivo" y proactivo.
Qué suele haber dentro de un harness
No existe una única arquitectura, pero varias piezas aparecen una y otra vez.
Tools: la forma de actuar
Una tool es una capacidad que el harness expone al modelo con un nombre, una descripción, unos parámetros y un resultado.
En un agente de desarrollo pueden existir tools para:
search_code(query)
read_file(path)
edit_file(path, patch)
access_folder(path)
open_browser(url)
El modelo elige una tool y genera los argumentos. El harness valida esa petición, ejecuta la operación real y devuelve el resultado.
El diseño de estas tools importa mucho más de lo que parece. Un error que solo diga failed obliga al modelo a investigar casi desde cero. Un error que indique qué archivo falló, en qué línea y por qué le da información que puede usar en el siguiente paso.
Un loop y estado para trabajar durante varios pasos
Una tarea real rara vez se resuelve con una única llamada al modelo.
Primero hay que encontrar los archivos. Después leerlos. Luego modificar código. Más tarde aparecen errores de compilación o tests. Cada resultado cambia lo que conviene hacer a continuación.
Por eso el harness mantiene un loop: llama al modelo, ejecuta una acción, incorpora el resultado y vuelve a llamarlo.
También guarda estado fuera del modelo. Puede conservar qué archivos se han revisado, qué cambios se hicieron, qué comandos fallaron o qué parte del objetivo sigue pendiente.
Contexto: decidir qué merece entrar
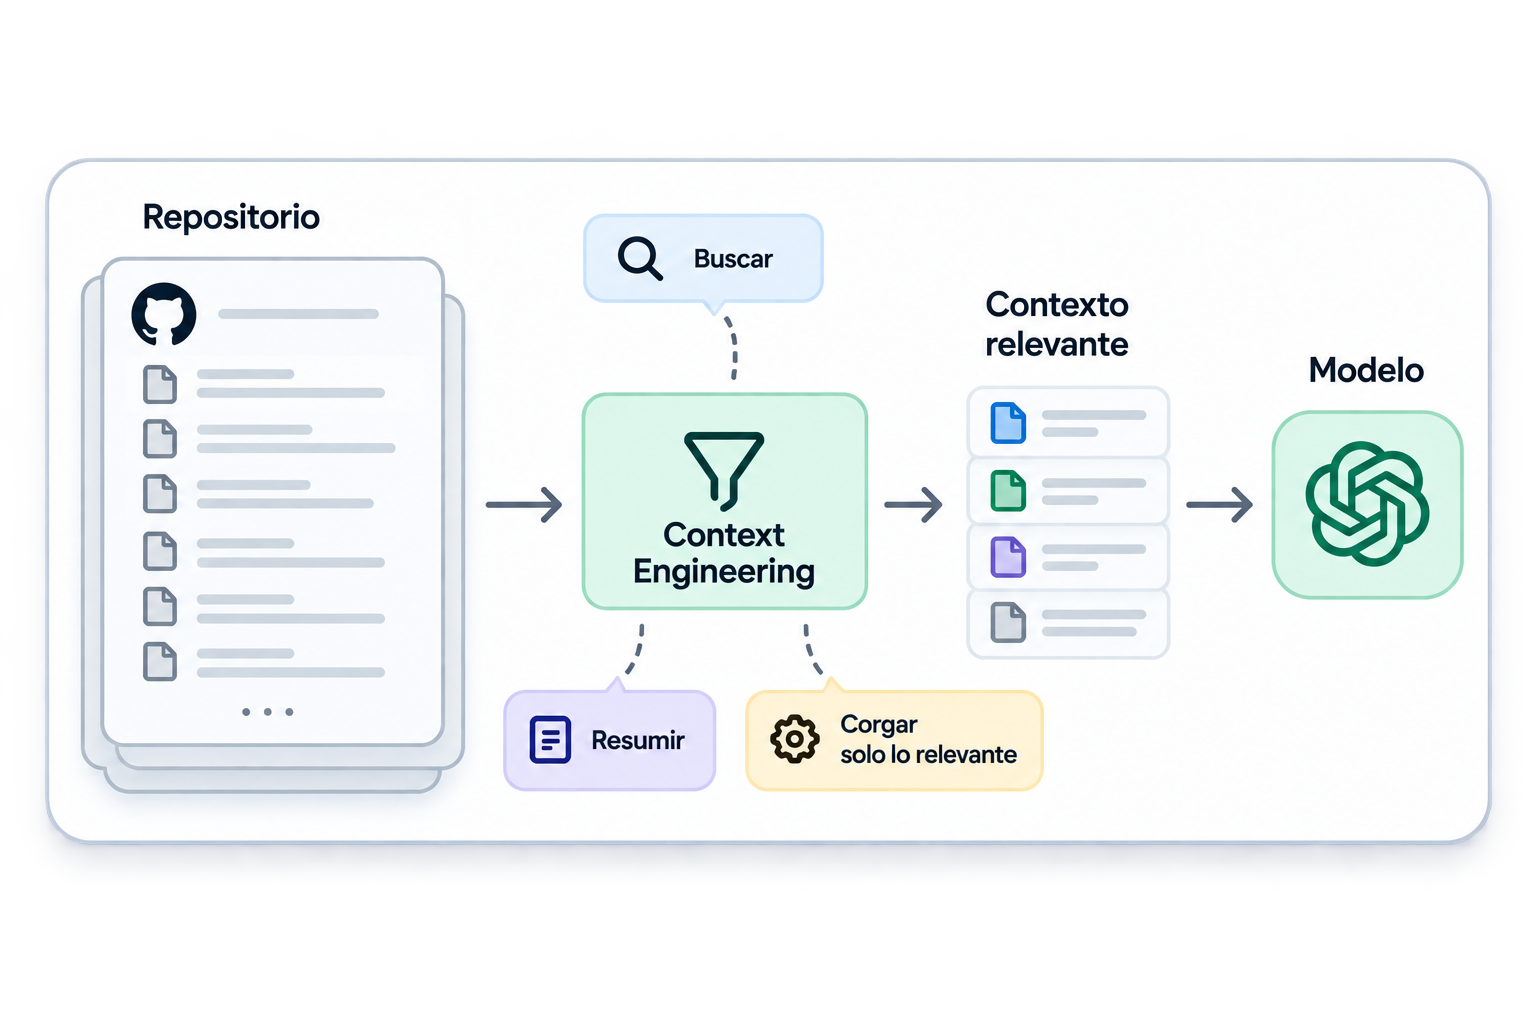
Un repositorio completo puede contener cientos de miles de líneas. Enviar todo al modelo en cada llamada sería caro, ruidoso y, en muchos casos, imposible.
El harness tiene que elegir.
Puede empezar con un mapa pequeño del proyecto, permitir búsquedas bajo demanda y cargar archivos solo cuando son relevantes. También puede resumir partes antiguas de una ejecución cuando el historial crece demasiado.
Eso es parte de lo que hoy llamamos Context Engineering.
El context engineering, por tanto, vive dentro de un problema mayor. Elegir el contexto es una responsabilidad del harness, pero el harness también tiene que ejecutar acciones, mantener estado, aplicar permisos y verificar resultados.
Entorno y permisos
Si un agente puede ejecutar comandos, también puede ejecutar el comando equivocado.
Por eso los agentes serios no dependen únicamente de una instrucción del tipo “ten cuidado”. El harness puede limitar qué tools existen, qué rutas pueden modificarse, si hay acceso a red o qué acciones necesitan aprobación humana.
También puede trabajar dentro de un sandbox o una copia aislada del repositorio.
La diferencia es importante: una instrucción es algo que el modelo debe interpretar. Un permiso aplicado por software es un límite que el modelo no puede saltarse simplemente porque haya entendido mal el prompt.
Si en tu proyecto un agente solo debería leer producción pero nunca modificarla, esa restricción debería vivir en los permisos del sistema, no escondida en un párrafo del prompt.
Verificación: que “terminado” signifique algo
Uno de los errores más fáciles de cometer con agentes es aceptar como evidencia la propia respuesta del modelo.
Que el agente diga “los cambios funcionan” no significa que funcionen.
Un buen harness busca evidencia externa: tests, compilación, consultas a una API, capturas, navegación real por una interfaz o comprobaciones sobre una base de datos.
En el ejemplo de la LWC, terminar podría significar:
- el indicador aparece con el dato correcto;
- los tests Jest pasan;
- los tests Apex relacionados siguen funcionando;
- el build no introduce errores;
- no se han modificado archivos fuera del alcance de la tarea.
Según Anthropic, parece que funciona mejor separar el agente que hace el trabajo del que lo revisa. En sus pruebas con tareas de desarrollo largas, usan un generator que implementa la solución y un evaluator que comprueba que realmente cumple lo que se le pide.
La gracia es que el evaluator no tiene por qué fiarse de lo que dice el agente que ha escrito el código: puede probar la aplicación directamente, incluso usando el navegador, y verificar que todo funciona como debería.
Prompt Engineering, Context Engineering y Harness Engineering
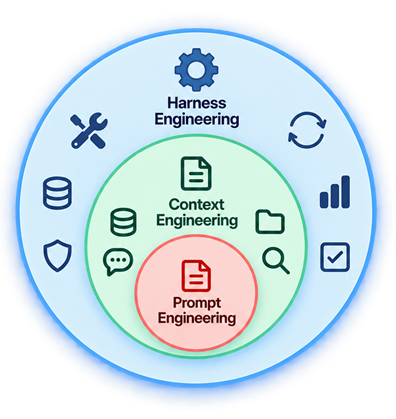
Los tres conceptos se solapan, pero no son equivalentes.
Prompt Engineering trabaja principalmente sobre las instrucciones que recibe el modelo: qué se le pide, cómo se describe la tarea y qué reglas debe seguir.
Context Engineering decide qué información acompaña a esas instrucciones en cada momento: historial, archivos, resultados de tools, documentación, memoria o datos recuperados bajo demanda.
Harness Engineering abarca el sistema completo que hace posible la ejecución. Incluye prompt y contexto, pero también tools, loops, estado, sandbox, permisos, observabilidad, verificación y evals.
También encaja aquí MCP. Un servidor Model Context Protocol puede ampliar las herramientas y fuentes de información disponibles para un agente. MCP no sustituye al harness: el harness decide cuándo exponer esas capacidades al modelo, cómo ejecutarlas y qué hacer con sus resultados.
Cómo se mejora un harness
La parte de engineering aparece cuando dejamos de tratar al agente como una caja negra.
Si algo falla, no basta con decir “el modelo se equivocó”. Hay que revisar qué información recibió, qué tools usó, qué errores encontró y por qué tomó ciertas decisiones.
Eso permite detectar patrones, ajustar prompts, tools o criterios y volver a probar.
El proceso acaba siendo bastante parecido al desarrollo de cualquier sistema:
ejecutar tareas
→ revisar resultados y trazas
→ encontrar un patrón de fallo
→ cambiar el harness
→ ejecutar las evaluaciones de nuevo
Harness Engineering es diseñar, medir y mejorar el software que rodea al modelo para que pueda completar trabajo real de forma controlada y verificable.
Cuando un agente encuentra el archivo correcto, ejecuta una tool, recuerda lo ocurrido veinte pasos atrás, pide permiso antes de una acción sensible o comprueba el resultado antes de decir que ha terminado, todo eso forma parte del harness.
El modelo sigue siendo importante. Pero el comportamiento del agente depende también de lo que construimos a su alrededor.
Sobre el Autor
Soy Guillermo Miranda, consultor Salesforce especializado en definir y desarrollar soluciones escalables para empresas.
¿Necesitas ayuda con Salesforce?
Ayudo a empresas a diseñar y construir soluciones Salesforce escalables.